Pilot Corpus for Tokenization and Lemmatization of Pannonian Rusyn – A First Step Toward Open Language Resources
- Hosting-Organisationen
- Universität Graz
- Verantwortliche Personen
- Marko Simonović
- Beginn
- Ende
Pannonisch-Rusinisch ist eine regionale Minderheitensprache, die vor allem in Teilen Serbiens und Kroatiens gesprochen wird. Obwohl die Sprache in Serbien auf allen Bildungsebenen unterrichtet wird und auch in den Medien der Sprachgemeinschaft präsent ist, stehen bislang kaum grundlegende digitale Sprachressourcen zur Verfügung.
Das Projekt setzt hier an und entwickelt ein linguistisch annotiertes Pilotkorpus für Pannonisch-Rusinisch. Damit entsteht eine Grundlage für weiterführende Arbeiten in den Bereichen Natural Language Processing, Korpuslinguistik und Digital Humanities. Zugleich soll das Projekt dazu beitragen, die Sprache stärker in offene europäische Forschungsinfrastrukturen einzubinden.
Über das Projekt
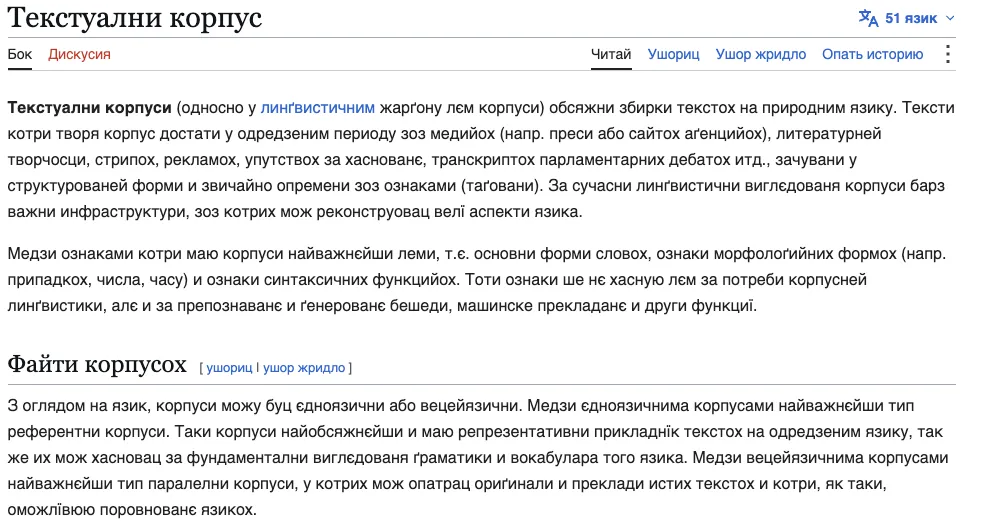
Als Textgrundlage für das Pilotkorpus dienen Beiträge aus der pannonisch-rusinischen Wikipedia. Der technische Workflow wurde beim ersten Projekttreffen am 31. Juli 2025 festgelegt und umfasst zwei zentrale Arbeitsschritte: Die Tokenisierung wird manuell überprüft und korrigiert. Anschließend werden den Tokens Lemmata und Wortartentags zugewiesen
Das geplante Pilotkorpus umfasst rund 10.000 Tokens. Die Daten werden manuell hinsichtlich Tokenisierung, Lemmatisierung und Wortarten annotiert. Für das Part-of-Speech-Tagging kommt ein vereinfachtes Tagset zum Einsatz.
Die aufbereiteten Daten werden im CoNLL-U-Format bereitgestellt. Ergänzend entstehen Annotationsrichtlinien und ein kurzer methodischer Bericht, die den Aufbau des Korpus und die getroffenen linguistischen Entscheidungen dokumentieren. Das standardisierte Datenformat und die begleitende Dokumentation sollen die Nachnutzung und Erweiterung des Korpus erleichtern.
An der Annotation beteiligen sich Ana Rimar Simunović, Aleksander Mudri und Aleksandra Dejanović von der Abteilung für Rusinistik in Novi Sad. Erste Ergebnisse des Projekts präsentierte Marko Simonović im Oktober 2025 im Rahmen der Veranstaltung CLASSLA-Express 1.0 Plus „Corpora meets AI“ in Graz.
Im Mittelpunkt der fachlichen Diskussion standen unter anderem die Lemmatisierung grammatisch gemischter Kategorien – insbesondere adjektivischer und adverbialer Partizipien – sowie deren Einordnung in einen breiteren Vergleich slawischer Sprachen.
Nach Projektabschluss soll das Pilotkorpus unter einer offenen Lizenz veröffentlicht und über CLARIN.SI oder ein geeignetes institutionelles Repositorium dauerhaft zugänglich gemacht werden.